QEMU TCG 与 KVM 的地址翻译机制
Junze Cao
转载声明:本文转载自 QEMU Camp 2026 训练营博客,版权归原作者所有。
原文作者:@yuanyiboyyb
原文链接:https://qemu.gevico.online/blogs/2026/professional/qemu-camp-2026-yuanyiboyyb/
背景介绍
本文为 yuanyiboyyb 在 QEMU 训练营 2026 专业阶段的学习笔记,主要围绕 QEMU 内存管理、TCG、执行循环和设备管理展开。
专业阶段
内存管理
无 kvm
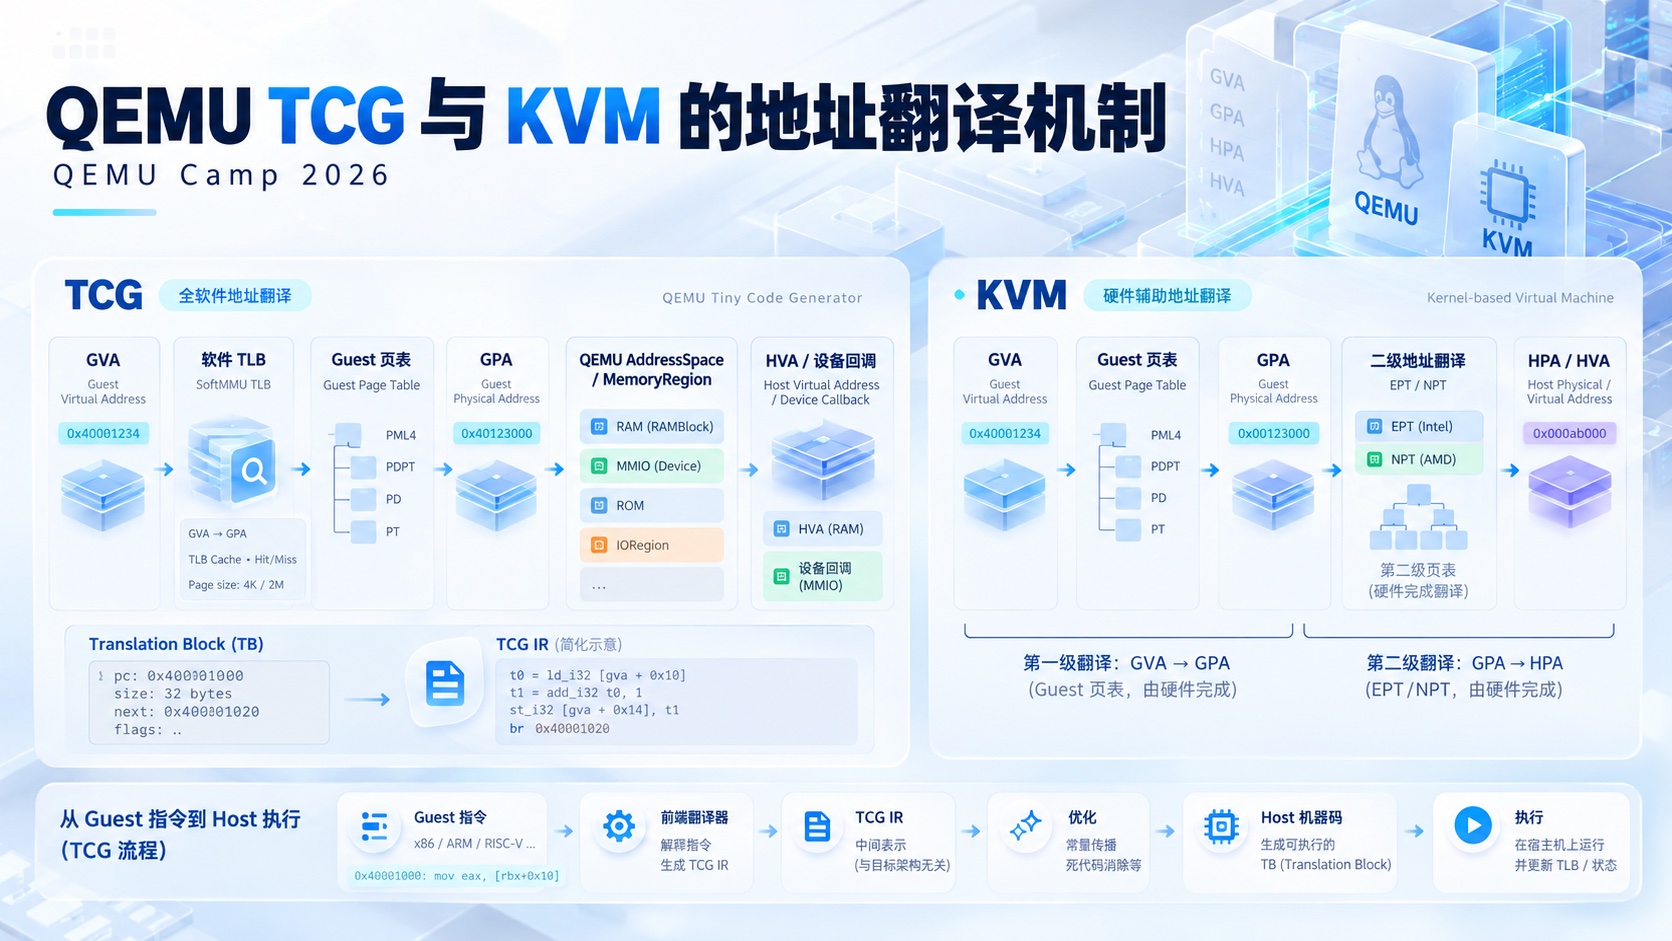
guest 的代码在 tcg 翻译时,对于需要内存访问的指令,插入一个内置的地址查询函数,从软件维护的 tlb 中查询,如果不命中,则先根据软件维护的 guest 页表翻译为 GPA,GPA 根据 qemu 维护的 AddressSpace / MemoryRegion 转换成 HVA,或者触发设备回调,并把 HVA 和 GVA 的映射关系储存到软件 tlb 中。如果命中,直接获取到对应的 HVA,GPA 根据 MemoryRegion 转换为 HVA,此 HVA 属于 qemu 进程地址空间,直接执行由进程页表翻译到 HPA。
有 kvm
GVA(guest virtual address) 经过由 guest 自己维护的页表翻译成 GPA(guest physical address),GPA 是 guest 视角下的物理地址空间,它模拟了一台真实机器的物理内存布局,通常从 0x0 开始编号;但它只是虚拟机内部看到的物理地址,不等于 host 上真正的物理地址 HPA,在 KVM 模式下,CPU 硬件 MMU 会根据 guest 当前页表完成第一级地址翻译,也就是 GVA 到 GPA。之后 GPA 有 kvm 维护的 EPT/NPT 页表翻译到 HPA(host physical address) 执行。
- 有 kvm 两级页表,两级由硬件完成
- 无 kvm 两级页表,一级软件一级硬件
TCG
TCG(Tiny Code Generator),也就是 QEMU 的动态二进制翻译引擎。它的作用是:把“客户机 CPU 指令”翻译成“宿主机 CPU 指令”,从而让不同架构的程序或操作系统能够在当前机器上运行。
Guest 指令
   ↓
前端翻译器
   ↓
TCG IR
   ↓
优化
   ↓
后端代码生成器
   ↓
Host 机器码
   ↓
执行
Translation Block,简称 TB
TCG 不是一条指令一条指令地执行,而是以 Translation Block 为单位翻译。
一个 TB 通常是一段连续的 guest 指令,直到遇到:
分支跳转
异常边界
页边界特殊
CPU 状态变化
但是在翻译 TCG 生成一个 TB 时,qemu 会给 TCG 中插入一些操作来模拟真机的操作
中断
- 真机里对中断的检查是在指令周期的中断周期中,所以每条指令都有可能检查中断。
- 而 qemu 无 kvm 中是在运行完一次 TB 执行后检查,上文中
cpu_handle_interrupt(cpu, &last_tb)就是负责检查中断,之所以不是运行完一个 tb 就检查呢,是因为上文中tb_add_jump(last_tb, tb_exit, tb)会使用跳跃指令连接两个 tv,导致一次可能会执行多个 tb。 - 由 kvm 提供系统调用给运行 vcpu 的真 cpu 直接发送中断信号,处理逻辑与真机一致
异常
- 无 kvm
- 翻译时可判断的直接插入 call helper 函数,无法知道的就添加运行时检查逻辑如果确实出现异常就 call helper,由 helper 跳转到 guest 的异常处理入口
- kvm
- vCPU 加载到真 CPU 时,会把 guest 的异常处理表基地址(IDT)加载到真 CPU 储存这个的寄存器上,所以运行时完全和真机一致,guest 内核代码和硬件来外层保护现场跳转到异常处理入口
总体来说是这个逻辑,但个别会有些特殊。
- vCPU 加载到真 CPU 时,会把 guest 的异常处理表基地址(IDT)加载到真 CPU 储存这个的寄存器上,所以运行时完全和真机一致,guest 内核代码和硬件来外层保护现场跳转到异常处理入口
| 操作 | 有 kvm | 无 kvm |
|---|---|---|
| 内存访问(load/store) | 页表查询等都由硬件来完成,与真机一致 | 每一处内存访问前都插入一个软件函数用来模拟 tlb,查询页表,cache,缺页等一一系列逻辑来获取物理地址,然后真正执行指令时用这个操作(当然硬件模拟并不是和真机一摸一样,相对简单) |
| Guest 访问 MMIO,port I/O | QEMU 地址翻译发现不是 RAM,调用设备回调;必要时退出 TB | CPU 二级翻译发现是 MMIO,KVM_RUN 返回 KVM_EXIT_MMIO,QEMU 处理设备 |
| 调试/断点 | 无 KVM 下,一个 TB 往往只翻译一条指令 helper 在翻译时就加入检测逻辑,每条指令都可单独触发调试事件。 |
KVM_EXIT_DEBUG 或架构调试退出 |
| HLT/WFI/等待中断 | helper 模拟 CPU halt,退出 TB 回到主循环,等待外部事件唤醒 guest | CPU 自身进入 halted 状态。guest 行为与真机一致,无需 helper。 |
| 关机/reset | 设置退出原因,返回上层主循环 | KVM_EXIT_SHUTDOWN 等返回 QEMU |
| 内部错误 | QEMU 自己报错/abort/退出 | KVM_EXIT_INTERNAL_ERROR / KVM_EXIT_FAIL_ENTRY |
执行循环
首先是总的循环
do {
    if (cpu_can_run(cpu)) {
        int r;
        bql_unlock();  // 释放 Big Qemu Lock(允许其他 CPU/线程并行访问资源)
        r = tcg_cpu_exec(cpu); // 执行 guest 指令块 (Translation Block),这是 vCPU 执行路径
        bql_lock(); // 再次获取锁,保证接下来的状态操作安全
        /* 根据 tcg_cpu_exec 返回值处理特殊事件/异常 */
        switch (r) {
            case EXCP_DEBUG:              // 如果是调试异常
                cpu_handle_guest_debug(cpu); // 调用调试处理函数
                break;
            case EXCP_ATOMIC:             // 如果是原子操作异常
                bql_unlock();                 // 解锁
                cpu_exec_step_atomic(cpu);    // 逐步执行原子操作指令
                bql_lock();                   // 再次加锁
                break;
            default:                       // 其他情况忽略
                break;
        }
    }

    qatomic_set_mb(&cpu->exit_request, 0); // 清除退出请求标志,保证下次循环可以正常执行
    qemu_wait_io_event(cpu); //事件循环

} while (!cpu->unplug || cpu_can_run(cpu));
- 可以发现主循环里主要有两个循环,一是 vcpu 执行循环
tcg_cpu_exec,二是事件循环qemu_wait_io_event - vCPU 执行循环
- 执行 guest 指令块(Translation Block,TB),模拟虚拟 CPU 的指令流。
- 处理异常和特殊指令,例如调试异常(EXCP_DEBUG)或原子指令(EXCP_ATOMIC)。
- 事件循环
- 处理外设 I/O 事件,比如后端连接的 tty 写入,会把回调函数挂载到事件队列里,执行循环时取出调用回调函数,讲数据写入到设备状态里并触发中断
- 调用定时器和事件回调,处理到期任务。
vCPU 执行循环
- tcg_cpu_exec 最终会调用 cpu_exec_loop
static int __attribute__((noinline))
cpu_exec_loop(CPUState *cpu, SyncClocks *sc)
{

    int ret;
	//检查是否有挂起的异常需要处理,如果有异常且需要退出
    while (!cpu_handle_exception(cpu, &ret)) {

        TranslationBlock *last_tb = NULL;

        int tb_exit = 0;


		//检查是否有挂起的中断需要处理,如果有则退出到外层循环,由外层来处理
        while (!cpu_handle_interrupt(cpu, &last_tb)) {
			//当前要执行的TCG块的指针
            TranslationBlock *tb;
            vaddr pc;
            uint64_t cs_base;
            uint32_t flags, cflags;
            cpu_get_tb_cpu_state(cpu_env(cpu), &pc, &cs_base, &flags);
            /*
             * When requested, use an exact setting for cflags for the next
             * execution.  This is used for icount, precise smc, and stop-
             * after-access watchpoints.  Since this request should never
             * have CF_INVALID set, -1 is a convenient invalid value that
             * does not require tcg headers for cpu_common_reset.
             */

            // 检查是否需要使用特殊的标志位(`cpu->cflags_next_tb`)。
			// 如果没有特殊要求,使用默认标志位(`curr_cflags(cpu)`)。
			// 如果使用了特殊标志位,执行后将其重置为默认状态(`-1`),以便后续 TB 恢复正常行为。
            cflags = cpu->cflags_next_tb;
            if (cflags == -1) {
                cflags = curr_cflags(cpu);
            } else {
                cpu->cflags_next_tb = -1;
            }
			//断点需要跳出循环,由外层循环处理
            if (check_for_breakpoints(cpu, pc, &cflags)) {
                break;
            }
			//找到tb,无缓存则翻译
            tb = tb_lookup(cpu, pc, cs_base, flags, cflags);
            if (tb == NULL) {
                CPUJumpCache *jc;
                uint32_t h;
                mmap_lock();
                tb = tb_gen_code(cpu, pc, cs_base, flags, cflags);
                mmap_unlock();
                //缓存翻译结果,以后使用
                //是一个键值对,但是存储空间有限,键重复的会把原先的覆盖,所以需要存储pc的原值负责比对
                //注意只存储了(pc,tb)键值对,但是不同进程空间pc会重叠,所以tb下回存储其他上下文信息。
                h = tb_jmp_cache_hash_func(pc);
                jc = cpu->tb_jmp_cache;
                jc->array[h].pc = pc;
                qatomic_set(&jc->array[h].tb, tb);
            }


//用户模式下可给tb结尾增加一个跳转指令来合并tb,系统模式下有换页等问题在tb处于不同分页时不进行这个操作,处于同一页内增加跳转指令
#ifndef CONFIG_USER_ONLY
            if (tb_page_addr1(tb) != -1) {
                last_tb = NULL;
            }
#endif
            if (last_tb) {
                tb_add_jump(last_tb, tb_exit, tb);
            }


			//执行tv
            cpu_loop_exec_tb(cpu, tb, pc, &last_tb, &tb_exit);

			align_clocks(sc, cpu);
        }
    }
    return ret;
}
事件循环
qemu_wait_io_event(cpu)最终会调用这个函数。具体是什么样的回调,下文设备管理中完全模拟 uart 后端接收就是一个例子
void process_queued_cpu_work(CPUState *cpu)
{
    struct qemu_work_item *wi;
    qemu_mutex_lock(&cpu->work_mutex);
    if (QSIMPLEQ_EMPTY(&cpu->work_list)) {
        qemu_mutex_unlock(&cpu->work_mutex);
        return;
    }
    while (!QSIMPLEQ_EMPTY(&cpu->work_list)) {
        wi = QSIMPLEQ_FIRST(&cpu->work_list);//取出队列里的回调函数
        QSIMPLEQ_REMOVE_HEAD(&cpu->work_list, node);
        qemu_mutex_unlock(&cpu->work_mutex);
        if (wi->exclusive) {
            bql_unlock();
            start_exclusive();
            wi->func(cpu, wi->data);//执行回调
            end_exclusive();
            bql_lock();
        } else {
            wi->func(cpu, wi->data);
        }
        qemu_mutex_lock(&cpu->work_mutex);
        if (wi->free) {
            g_free(wi);
        } else {
            qatomic_store_release(&wi->done, true);
        }
    }
    qemu_mutex_unlock(&cpu->work_mutex);
    qemu_cond_broadcast(&qemu_work_cond);
}
设备管理
QOM
- QOM(QEMU Object Model) 是 QEMU 提供的一套对象系统,用于:
- 动态 注册类型(type)
- 实例化对象(例如各种设备、芯片模型等)
- 支持 单继承 + 多继承接口
- 提供对对象属性(properties)的统一访问接口
- 它类似于一个简化版的 C++/Java 类系统,但是是在 C 语言环境下实现的。
(qemu) info qom-tree
/ (TYPE_OBJECT)
├─ machine@pc                   # 主机/Board 对象
│   ├─ cpu0@                   # CPU 0
│   ├─ cpu1@                   # CPU 1
│   ├─ memory@ram              # RAM 对象
│   ├─ bus@pcie.0              # PCI Express 总线
│   │   ├─ root-port@16        # 根 PCIe 端口
│   │   ├─ virtio-net-pci@…    # virtio 网络设备
│   │   └─ virtio-blk-pci@…    # virtio 块设备
│   ├─ bus@isa.0               # ISA 总线
│   │   ├─ serial@…            # 16550 串口设备
│   │   ├─ rtc@…               # RTC 实时时钟
│   │   └─ pit@…               # Programmable Interval Timer
│   ├─ ide-cd@…                # IDE 光驱
│   ├─ vga@…                   # VGA 显卡
│   └─ usb-controller@…        # xHCI USB 控制器
└─ chardevs                    # 字符设备层
    ├─ chardev-vt100@…         # tty 相关
    └─ chardev-stdio@…         # Mon/Serial 映射
struct DeviceState {
	Object parent_obj; /* QOM 父类对象:DeviceState 继承 Object */

	/* 设备通用状态:id、realized、父 bus、子 bus、reset、hotplug、GPIO/IRQ、属性等 */
	...
};

struct PCIDevice {
	DeviceState qdev; /* QOM 父类对象:PCIDevice 继承 DeviceState */

	/* PCI 通用状态:config space、BAR、devfn、DMA、INTx/MSI/MSI-X、capability、option ROM 等 */
	...
};
- 可以看到有这么一个结构体,就是“对象实例”,每创建一个 serial 设备,就有一个 SerialState。
另一层是 class,类似
struct PCIDeviceClass {
	//PCIDeviceClass 继承 DeviceClass
    DeviceClass parent_class;
    //PCI 自己新增的方法 虚方法槽
    void (*realize)(PCIDevice *dev, Error **errp);
    PCIUnregisterFunc *exit;
    PCIConfigReadFunc *config_read;
    PCIConfigWriteFunc *config_write;
    //自己新增的字段:这些字段是所有设备示例公用的,比如设备号什么的
    uint16_t vendor_id;
    uint16_t device_id;
    uint8_t revision;
    uint16_t class_id;
    uint16_t subsystem_vendor_id;       /* only for header type = 0 */
    uint16_t subsystem_id;              /* only for header type = 0 */
    const char *romfile;                /* rom bar */
};
-
一个类型只有一个 class object,所有同类型实例共享它。QEMU 官方文档也明确说,每个类型都有一个 ObjectClass,通常保存虚方法函数指针表;而实例对象可以有很多个。
-
所以说一个是实例化对象,一个是虚函数表以及一些公用成员,来实现 OOM。
-
如果需要重载父类方法,就通过一个运行时初始化函数来实现
当然,如果 class 如果没有需要新加的字段,直接使用父类 class 再重载就可以,不需要定义自己的 class
static void pci_device_class_init(ObjectClass *klass, void *data)
{
	//kclass实际类型就是PCIDeviceClass,通过计算指针地址变异获取父类指针,然后覆盖方法
    DeviceClass *k = DEVICE_CLASS(klass);
    k->realize = pci_qdev_realize;
    k->unrealize = pci_qdev_unrealize;
    k->bus_type = TYPE_PCI_BUS;
    device_class_set_props(k, pci_props);
    object_class_property_set_description(
        klass, "x-max-bounce-buffer-size",
        "Maximum buffer size allocated for bounce buffers used for mapped "
        "access to indirect DMA memory");
}
完全模拟
- QEMU 独立实现设备逻辑,无需宿主机设备支持。且一般都是直接或者延时(运行几个 TB 后)调用回调,不用开线程
- 优点:可在任何平台上运行,独立性高。
- 缺点:性能相对低,因为所有设备逻辑都由 QEMU CPU 模拟。
- 例子:
- CPU/内存:
qemu32,qemu64,pentium,core2duo,arm1176,cortex-a8,cortex-a15,rv32,rv64; - 存储:
ide-hd,ide-cd,pci-ide,lsi53c895a,megasas,qcow2,raw,vmdk; - 网络:
e1000,e1000e,rtl8139,ne2k_pci,usb-net; - 显示:
cirrus-vga,std,qxl,vga,virtio-gpu-fb; - 输入:
ps2-keyboard,ps2-mouse,usb-mouse,usb-kbd; - 总线/桥:
pci-root,i440fx,usb-ohci,usb-ehci,usb-xhci; - 其他:
i82489dx,serial,parallel,ac97,sb16.
- CPU/内存:
以 16550 UART 为例看一下设备如何执行
- TCG 翻译模式下,内存访问会修改成插入一个 helper 函数根据内存区域表来决定是向内存单纯写,还是发现是一个设备的区域调用设备回调
- kvm 模式下,硬件提供的第一级页表发现是设备区域就会退出 kvm 模式,会触发一个
KVM_EXIT_MMIO或KVM_EXIT_IO事件,qemu 根据事件消息来触发回调 - uart 设备挂靠在 isa 总线下,但是模拟的 isa 总线只是一个注册分发机制,注册回调函数到指定的内存区域,通过 MemoryRegion 层层分发
struct MemoryRegion {
    /* 父 MemoryRegion / 上一级表 */
    MemoryRegion *container;
    /* 子区域表,挂载在该区域下的子设备或子 MemoryRegion */
    QTAILQ_HEAD(, MemoryRegion) subregions;
    /* 链表节点,用于挂在父 MemoryRegion 的 subregions 链表 */
    QTAILQ_ENTRY(MemoryRegion) subregions_link;
    /* 如果该区域是别名,指向原始区域及偏移 */
    MemoryRegion *alias;
    hwaddr alias_offset;
    /* 冲突处理优先级 */
    int32_t priority;
    /* 回调函数表 */
    const MemoryRegionOps *ops;
    void *opaque;
    /* 名称,调试/对象树显示 */
    const char *name;
    ……
};

const MemoryRegionOps serial_io_ops = {
    .read = serial_ioport_read,
    .write = serial_ioport_write,//读写回调
    .valid = {
        .unaligned = 1,
    },
    .impl = {
        .min_access_size = 1,
        .max_access_size = 1,
    },
    .endianness = DEVICE_LITTLE_ENDIAN,
};

// 为设备创建一个 **MemoryRegion**,用于映射设备寄存器或 I/O 端口空间
memory_region_init_io(&s->io, OBJECT(isa), &serial_io_ops, s, "serial", 8);
//把 UART 的 MemoryRegion **挂载到 ISA 总线的 I/O 端口空间**
isa_register_ioport(isadev, &s->io, isa->iobase);
也就是是说对 uart 对应内存区域读写会触发serial_ioport_read和serial_ioport_write
serial_ioport_write写数据的逻辑
case 0:
    // 如果 LCR 寄存器的 DLAB 位被设置,端口 0 不是 THR,而是 DLL(波特率低字节)
    if (s->lcr & UART_LCR_DLAB) {
        // 更新波特率低字节
        s->divider = deposit32(s->divider, 8 * addr, 8, val);
        // 根据新波特率参数更新内部传输时间、定时器等
        serial_update_parameters(s);
    } else {
        // DLAB=0,端口 0 为 THR(发送寄存器),写入要发送的数据
        s->thr = (uint8_t) val;
        // 如果启用了 FIFO
        if(s->fcr & UART_FCR_FE) {
            // FIFO 满了,先丢弃最旧的数据腾出空间(硬件特性:overrun overwrite)
            if (fifo8_is_full(&s->xmit_fifo)) fifo8_pop(&s->xmit_fifo);
            // 将新写入的数据放入发送 FIFO
            fifo8_push(&s->xmit_fifo, s->thr);
        }
        // 清除发送中断等待标志(写 THR 后,THR 中断状态已处理)
        s->thr_ipending = 0;
        // 清除 LSR 寄存器中的 THR Empty 和 Transmitter Empty 位
        // 因为写入了新数据,发送寄存器不再为空
        s->lsr &= ~UART_LSR_THRE;
        s->lsr &= ~UART_LSR_TEMT;
        // 更新中断线状态,如果需要触发中断,调用 qemu_set_irq()
        serial_update_irq(s);
        // 如果当前没有发送重试任务,则立即启动发送
        // 这会将 FIFO 中的数据通过 back-end 输出(例如控制台或虚拟串口)
        if (s->tsr_retry == 0) serial_xmit(s);
    }

//先模拟向寄存器写和向fifo写两种可能,最终调用serial_xmit(s)来输出,而serial_xmit最红调用了
int qemu_chr_fe_write(CharBackend *be, const uint8_t *buf, int len)
{
    Chardev *s = be->chr;
    if (!s) {
        return 0;
    }
    return qemu_chr_write(s, buf, len, false);
}
CharBackend(字符设备后端) 是 QEMU 的抽象层,它提供统一接口,让 UART、串口、虚拟机监控台等输出“字符数据”,将其输出到主机的 TTY/串口,控制台窗口,文件,TCP/UDP socket,管道,使用-serial /dev/ttyS0 -serial file:out.txt -serial tcp:127.0.0.1:port,server指定后端实例是什么,这些与实例交互的后端会开一个线程
serial_ioport_read读取数据的逻辑
case 0:
    if (s->lcr & UART_LCR_DLAB) {
        // 读取 DLL(波特率低字节)
        ret = extract16(s->divider, 8 * addr, 8);
    } else {
        if(s->fcr & UART_FCR_FE) {
            // FIFO enabled → 从 FIFO 弹出
            ret = fifo8_is_empty(&s->recv_fifo) ? 0 : fifo8_pop(&s->recv_fifo);
            ...
        } else {
            // FIFO disabled → 直接读寄存器 RBR
            ret = s->rbr;
            s->lsr &= ~(UART_LSR_DR | UART_LSR_BI);
        }
        serial_update_irq(s);
        ...
    }
    break;
这里寄存器的值和 fifo 的值是有单独线程的后端来填写,下面这个函数是后端设置有数据传来触发加入事件循环的回调,过程就是后端会将这个函数指针加入事件循环的回调队列里,然后等到了事件循环执行时逐个执行
//这个函数会绑定到后端的回调里,后端检测到比如tty有输入,就会触发这个函数,recv_fifo_put就会往fifo写
static void serial_receive1(void *opaque, const uint8_t *buf, int size)
{
    SerialState *s = opaque;
    if (s->wakeup) {
        qemu_system_wakeup_request(QEMU_WAKEUP_REASON_OTHER, NULL);
    }
    if(s->fcr & UART_FCR_FE) {
        int i;
        for (i = 0; i < size; i++) {
            recv_fifo_put(s, buf[i]);
        }
        s->lsr |= UART_LSR_DR;
        /* call the timeout receive callback in 4 char transmit time */
        //设置延时触发中断,避免这一次中断被忽略
        timer_mod(s->fifo_timeout_timer, qemu_clock_get_ns(QEMU_CLOCK_VIRTUAL) + s->char_transmit_time * 4);
    } else {
        if (s->lsr & UART_LSR_DR)
            s->lsr |= UART_LSR_OE;
	        s->rbr = buf[0];
	        s->lsr |= UART_LSR_DR;
    }
    serial_update_irq(s);
}
//一串数据到来,立刻触发中断,cpu可能只处理了前面已经到的数据,就结束了处理,后面到的数据需要延时中断来告知,这就是为什么设置定时器的原因
不过还有一件很神奇的事情,无论是对 fifo 的写还是对 fifo 的读,都是一个无锁操作,而后端和主循环是两个线程,为什么不会发生冲突呢,
实际上是主循环维持了一个事件队列,后端触发回调只是把回调加入事件队列,具体执行还是有主循环执行,主循环要么执行 guest 操作要么执行回调,根本不会有冲突。
Virtio 设备模拟
- Virtio 是 虚拟化设备标准,用于高性能虚拟化
- 核心特点:
- 客户机(Guest)通过 虚拟队列(Virtqueue) 传递请求
- Virtqueue 是 环形/循环队列(Ring Buffer)
- 设备驱动把 命令/请求描述符(Descriptor) 放入队列
以 virtio‑rng 设备为例
1 Guest 探测设备
- Guest 驱动扫描总线:
- 驱动读取 Virtio 特性寄存器(device features):
- 驱动初始化 virtio 状态机:
2 Guest (驱动完成) 分配 virtqueue 和 buffer 内存
-
分配 virtqueue 内存(guest kernel/驱动负责):
-
Descriptor Table:这里都是 qemu 测的结构体定义,驱动侧略有不同
C struct VirtQueue { // 描述符表、Available Ring 和 Used Ring 的内存布局 VRing vring; // 设备完成的元素列表,用于驱动回收/处理 VirtQueueElement *used_elems; // 下一个要从 Available Ring 弹出的描述符索引 uint16_t last_avail_idx; // last_avail_idx 对应的循环计数位(wrap bit) bool last_avail_wrap_counter; // 设备收到的最新可用描述符索引(优化用) uint16_t shadow_avail_idx; // shadow_avail_idx 对应的 wrap bit(Packed Ring) bool shadow_avail_wrap_counter; // 设备写入的 Used Ring 最新索引 uint16_t used_idx; // used_idx 对应的循环计数位 bool used_wrap_counter; // 上一次通知驱动的 used_idx uint16_t signalled_used; // signalled_used 是否有效 bool signalled_used_valid; // 队列是否开启通知机制 bool notification; // 队列在 VirtIODevice 中的索引 uint16_t queue_index; // 当前队列中正在使用的描述符数量 unsigned int inuse; // MSI/MSI-X 中断向量号 uint16_t vector; // 回调函数,用于设备输出数据给驱动 VirtIOHandleOutput handle_output; // 指向所属 VirtIODevice VirtIODevice *vdev; // Guest 侧事件通知 EventNotifier guest_notifier; // Host 侧事件通知 EventNotifier host_notifier; // Host notifier 是否启用 bool host_notifier_enabled; // 队列链表节点,用于链表管理 QLIST_ENTRY(VirtQueue) node; }; struct VRing { //数组大小 unsigned int num; // 下一个 available descriptor 的索引,用于 guest push 到 available ring int next_idx; // 下一个 used descriptor 的索引,用于 host/QEMU 写入 used ring int used_idx; // Descriptor Table 指针(数组),每个元素描述一个 buffer VRingDesc *desc; VRingAvail *avail;// Used Ring 指针,host/QEMU 完成请求后写入的环形队列 VRingUsed *used;// Used Ring 指针,host/QEMU 完成请求后写入的环形队列 SubChannelId schid;// 虚拟通道 ID(子通道),用于多队列或多通道设备区分 long cookie;// 通用 cookie,可用于驱动/设备自定义状态或回调参数 int id;// 队列 ID,用于区分同一设备下的多个 virtqueue }; struct VRingDesc { //guest 的物理地址 uint64_t addr; //buffer 的长度 uint32_t len; //位图表示 //bit 000 表示这个 descriptor 后面还有下一个 descriptor //bit 001 表示这个 buffer 是 **device 可写** 的。 //bit 010 表示 `addr` 指向的不是普通数据 buffer,而是另一个 descriptor table。 uint16_t flags; //下一个 descriptor 的索引号,在 table 中的索引 uint16_t next; } __attribute__((packed)); typedef struct VRingDesc VRingDesc;- Available Ring:
typedef struct VRingAvail { // guest 给 device 的标志位 uint16_t flags; // guest 已经放入 available ring 的 descriptor 数量计数 uint16_t idx; // descriptor table 的索引数组 // 每一项都是一个 descriptor index,不是地址 uint16_t ring[]; } VRingAvail; - Used Ring:
typedef struct VRingAvail {
    // guest 给 device 的标志位
    uint16_t flags;
    // guest 已经放入 available ring 的 descriptor 数量计数
    uint16_t idx;
    // descriptor table 的索引数组
    // 每一项都是一个 descriptor index,不是地址
    uint16_t ring[];
} VRingAvail;
- Available Ring:
3 Guest 告知 Virtio 设备 virtqueue 物理地址
- 通过向对应的 MMIO 写回触发 qemu 回调
static void virtio_ioport_write(void *opaque, uint32_t addr, uint32_t val)
{
    VirtIOPCIProxy *proxy = opaque;
    VirtIODevice *vdev = virtio_bus_get_device(&proxy->bus);
    uint16_t vector, vq_idx;
    hwaddr pa;
	switch (addr){
		…………
		case VIRTIO_PCI_QUEUE_PFN:
        pa = (hwaddr)val << VIRTIO_PCI_QUEUE_ADDR_SHIFT;
        if (pa == 0) {
            virtio_pci_reset(DEVICE(proxy));//清空virtioqueue
        }
        else
            virtio_queue_set_addr(vdev, vdev->queue_sel, pa);//设置virtioqueue,也就是VRing指针
        break;
		…………
	 }
}
4 Guest 设置请求,写入 Descriptor Table(来源 linux virtio-rng 设备驱动)
- 上层给 guest 驱动的数据常常是分散内存,不一定连续;用 virtio 的 descriptor 链可以直接描述这些分段,避免先拷贝拼成一整块。
- guest 驱动维护 desc[] 的空闲索引池(通常是“空闲头索引 + next 索引链”),分配请求时从空闲链取索引。
- 对请求涉及的每一段内存(包含给设备读的段、设备写回复的段,当然也可以都用一段内存,比如 virtio-rng 设备),guest 填充一个 VRingDesc:addr 是该段地址,len 是长度,flags 标识读写/是否还有下一段,next 指向下一段索引。
- 这些 VRingDesc 通过 next 串成一个请求链后,把链头索引写入 VRingAvail.ring[],再递增 VRingAvail.idx,设备就能按这个头索引去取整条请求链处理。
- guest 往一个 mmio 寄存器写来触发 qemu 的回调函数通知设备
5 qemu virtio 设备处理请求写回复
- 回调函数会把真正执行函数挂载到事件循环的队列里,跟之前的 uart 后端有输入时把写入设备状态的函数放入队列的机制一致,也就是说 rng 后端不是单独的进程,这里跟 uart 的不太一样,真正执行的函数会优先使用
getrandom()系统调用,或者open("/dev/urandom")后read(),/dev/urandom不存在再退到/dev/random。然后写入之前与 guest 约定好的内存区域,然后触发中断
硬件直通
cpu 虚拟化状态位
- CPU 内部增加一个 虚拟化状态位(Intel VMX non-root / AMD Guest Mode),标记当前执行上下文是 Guest。
- 物理寄存器共享,但通过 VMCS / VMCB 保存 Guest 和 Host 状态,实现寄存器切换。
- 普通指令直接执行,敏感指令触发 VM exit → Hypervisor 处理。VMCS / VMCB 本质上是一组“不可运算的寄存器状态存储区”,与正常物理寄存器数量相同,用于保存 Guest/Host 寄存器状态,实现虚拟化下的安全切换
二级页表机制(EPT / NPT)0
- Guest 页表:Guest OS 自己维护 GVA → GPA(虚拟地址 → Guest 物理地址)
- EPT / NPT:硬件 + KVM 将 GPA → HPA(Host 物理地址)
- CPU 硬件自动完成两级地址转换,必要时触发 EPT/NPT fault → KVM 修正。
硬件直通
- IOMMU(Intel VT-d / AMD-Vi)
- CPU / 芯片组内建 DMA remapping 单元。
- 每个 PCIe 设备通过 IOMMU group 关联访问权限。
- 设备的 DMA 请求经过 IOMMU 转换,最终映射到 Host 物理内存。
- VFIO(Virtual Function I/O)其实是一个内核模块
- 管理 PCI/Platform 设备的绑定和解绑。
- 配置 IOMMU 表,确保 DMA 访问隔离。
- 提供 用户态安全访问设备寄存器 的接口
原本有些设备只能驱动程序使用,现在提供一个在类似/dev/vfio/xxx这样的接口,可以通过open ioctl系统调用来操作,比如 GPU,高速网卡(PCIe 10G/25G 网卡),NVMe / 高速存储控制器,USB / 音频 / FPGA 等 PCIe 设备
总结
这篇笔记从地址翻译、TCG 执行、QEMU 主循环、QOM 设备建模、Virtio 设备模拟和 VFIO 直通等角度梳理了专业阶段学习中形成的 QEMU 系统理解。