创新资助计划 | 面向复杂视频场景的人脸伪造检测实践
陈秋实
随着 AI 换脸技术的发展,视频中的人脸越来越难以仅凭肉眼判断真伪。当画面中出现多个人物,或镜头远近不断变化时,检测还需要考虑不同人物、不同时间和不同人脸尺寸之间的关系。
依托“网络安全学院学生创新资助计划”,在北京橙际科技有限公司的支持下,华中科技大学网络空间安全学院翟竑达、王连淼同学在周满老师指导下,开展了“基于多模态大模型的虚假人脸攻击检测”项目。
根据企业任务书,课题重点关注多模态特征提取与融合、虚假人脸检测模型设计,以及鲁棒性优化与对抗防御。项目围绕这些任务完成了人脸伪造检测模型的实现与实验评估,形成了一套虚假人脸检测系统和一份结项研究报告。
项目简介
项目结合已有视频鉴伪研究,面向多人同框、人脸尺寸变化和镜头景别切换等场景,采用身份感知与时空特征建模相结合的检测方案。模型同时分析面部纹理细节和跨帧动态变化,判断输入视频中是否存在人脸伪造。
在多人视频中,真实人脸与被篡改的人脸可能同时出现,人物的位置、大小和出场时间也各不相同。项目将人物身份、时间顺序和场景尺度纳入检测流程,让模型能够关联同一人物在不同帧中的表现,并综合利用局部细节与连续动作中的鉴伪线索,为复杂视频内容的真实性判断提供支持。
系统设计
检测流程由人脸预处理、特征提取、身份感知时序建模和视频级判别四个环节组成。系统首先逐帧定位并裁剪人脸,再通过特征相似性进行身份聚类,为同一人物构建跨帧人脸序列,同时记录帧位置与人脸相对面积。随后,特征提取网络与时序建模网络对这些信息进行分析,最终汇总特征并输出视频级真伪判断。
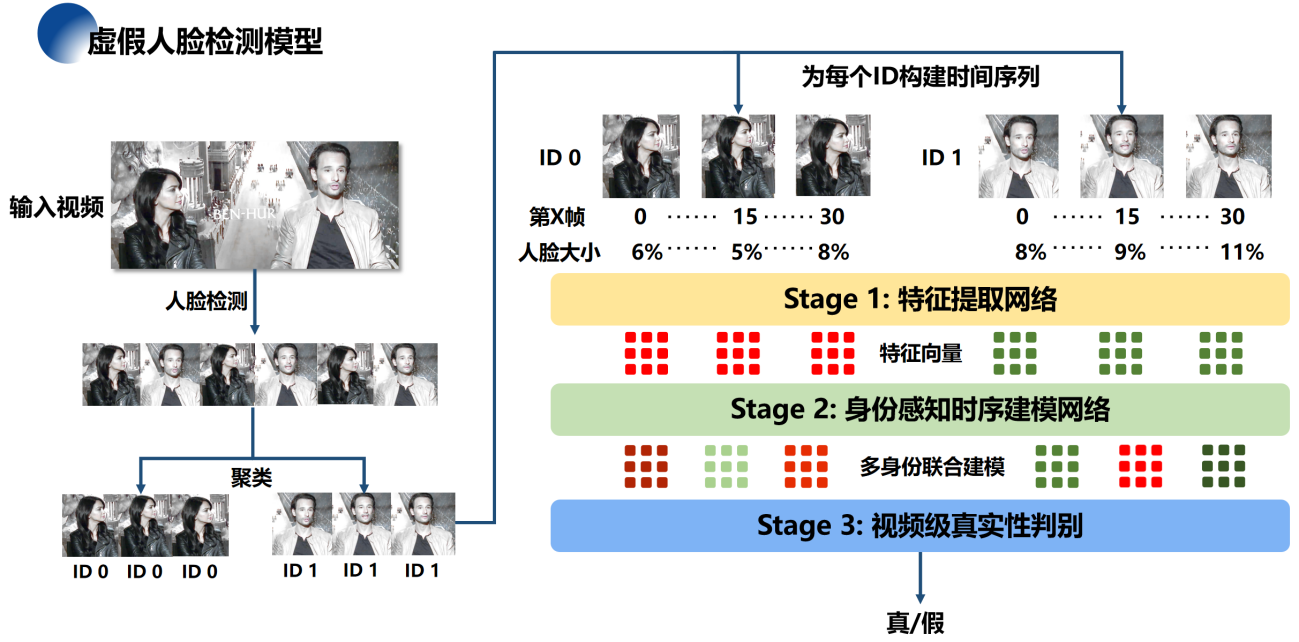
图 1 人脸伪造检测模型原理图,从人脸检测与身份聚类到视频级真伪判别。
模型围绕以下三个方面组织检测信息:
• 人物身份关联与时序建模: 根据人脸特征相似性,将同一人物在不同帧中的图像关联到对应的身份序列中,并通过身份掩码限制时序分析中的信息混合。这一处理让跨帧特征围绕同一人物展开,减少其他人物对局部伪造信号的干扰。
• 空间细节与跨帧变化分析: 通过卷积骨干网络提取面部纹理、光照和局部结构特征,再结合空间与时间注意力分析不同区域之间的关系及连续帧中的动态变化,将静态细节与时序线索共同用于真实性判断。
• 相对尺度信息融合: 在裁剪阶段记录人脸占原始画面的面积比例,将其编码为尺度特征并与视觉特征融合。这样,模型在分析人脸图像时也能获取原始场景中的尺寸信息,为不同景别和拍摄距离下的检测提供额外线索。
在判别阶段,模型通过全局聚合汇总不同帧与不同身份的特征,再由分类模块输出视频级检测结果。训练阶段结合分类损失与对比约束,对真假样本的特征表示进行优化,使数据预处理、特征建模和最终判别衔接为完整的检测流程。
实验结果
为了解模型在不同视频条件下的表现,项目选取 ForgeryNet 和 Celeb-DF v2 两个公开数据集开展评估。前者覆盖多种伪造方式与复杂场景,后者以视觉效果更自然、伪造痕迹更少的视频为特点,两组测试分别考察了模型在多样化样本和高质量伪造样本上的检测能力。
根据项目结项测试记录,主要结果如下:
|
数据集 |
AUC |
准确率 |
伪造检出率(TPR) |
|
|
ForgeryNet |
0.9320 |
85.58% |
86.84% |
|
|
Celeb-DF v2 |
0.9065 |
84.03% |
84.50% |
AUC 衡量模型在不同判别阈值下区分真伪的整体能力,准确率反映当前阈值下分类正确的样本比例,伪造检出率则表示测试集中被成功识别的伪造样本占比。三个指标共同呈现了模型的整体区分能力与实际分类表现。
ForgeryNet 测试结果: 模型的 AUC 达到 0.9320,准确率为 85.58%,伪造检出率达到 86.84%。在覆盖多种伪造方式与视频条件的测试集中,模型能够识别较大比例的伪造样本,这组结果为检测流程的有效性提供了实验依据。
Celeb-DF v2 测试结果: 模型的 AUC 为 0.9065,准确率为 84.03%,伪造检出率为 84.50%。面对视觉效果更自然、局部伪造痕迹更少的视频,模型取得了超过 0.90 的 AUC,体现了检测方案在高质量伪造样本上的区分能力。
综合两组实验,模型的 AUC 均超过 0.90,准确率与伪造检出率均超过 84%。这些结果表明,在本次评测条件下,检测方案能够对多样化伪造样本和高质量伪造样本进行较好的区分,为面向不同来源视频的鉴伪研究提供了实验基础。
本次创新资助计划项目完成了从数据预处理、身份关联、特征建模到性能评估的检测流程,将视频鉴伪研究与具体模型实现相结合。欢迎社区伙伴围绕多人场景检测、时空特征融合和视频鉴伪应用交流讨论。